
Роман: Давай всё-таки вернёмся к перцептрону.
Астра: Давай. Мы уже разобрались, как работает простейший искусственный нейрон. Он получает входные сигналы, умножает каждый на свой вес, складывает результаты и сравнивает сумму с порогом. Если сумма достигает порога, нейрон выдаёт единицу. Если нет — ноль.
Такой нейрон умеет выполнять простые логические операции «И» и «ИЛИ». Но есть задача, которую один перцептрон решить не может.
Задача, которую не решить одной прямой
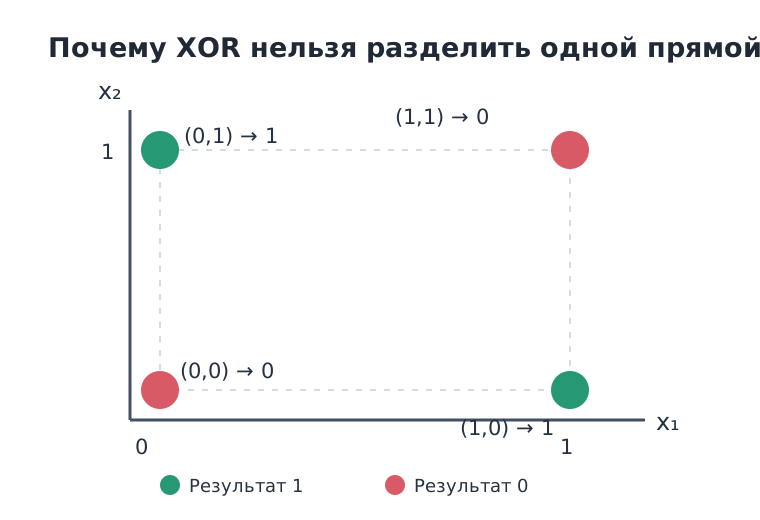
Астра: Представь логическую операцию XOR — исключающее «ИЛИ». Она выдаёт единицу, когда два входа различаются, и ноль, когда они одинаковые.
| Первый вход | Второй вход | XOR |
|---|---|---|
| 0 | 0 | 0 |
| 0 | 1 | 1 |
| 1 | 0 | 1 |
| 1 | 1 | 0 |
Как думаешь, можно ли подобрать веса и порог одного перцептрона так, чтобы он выполнял эту операцию?
Роман: Ну интуитивный ответ — нет.
Астра: И интуиция тебя не подвела. Один перцептрон с двумя входами разделяет точки на плоскости одной прямой. Для операций «И» и «ИЛИ» это возможно, а для XOR — нет. Две точки с результатом 1 лежат по диагонали квадрата, и две точки с результатом 0 — по другой диагонали. Одной прямой разделить их нельзя.
Это называется линейной неразделимостью.
Астра: А что, если вместо одного перцептрона взять два, а их результаты передать третьему? Как думаешь, они смогут решить задачу?
Роман: Интуитивный ответ — да.
Три нейрона решают XOR
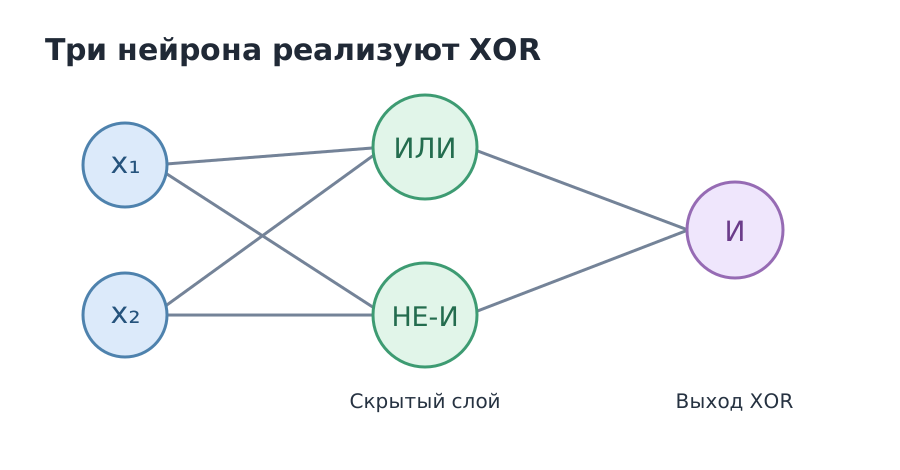
Астра: И снова правильно! Первый нейрон выполняет «ИЛИ»: хотя бы один вход должен быть единицей. Второй выполняет «НЕ-И» (NAND): выдаёт ноль только тогда, когда оба входа равны единице. Третий получает оба результата и выполняет «И».
| x₁ | x₂ | ИЛИ | НЕ-И | Результат |
|---|---|---|---|---|
| 0 | 0 | 0 | 1 | 0 |
| 0 | 1 | 1 | 1 | 1 |
| 1 | 0 | 1 | 1 | 1 |
| 1 | 1 | 1 | 0 | 0 |
Ни один нейрон в отдельности не выполняет XOR. Но вместе они получают правильный результат. Промежуточные нейроны преобразуют информацию так, что следующий слой способен решить задачу.
Астра: А как сделать так, чтобы сеть сама нашла нужные веса, не зная заранее, что ей нужны именно «ИЛИ» и «НЕ-И»?
Роман: Вообще не представляю.
Как нейросеть учится
Астра: Представим, что веса заданы случайно. Подаём входы 0 и 1. Правильный ответ для XOR — 1, но сеть, допустим, выдаёт 0. Значит, она ошиблась. Мы можем изменить веса и попробовать снова.
Трудность в том, что нейронов несколько и у каждого свои веса. Как понять, какой вес и насколько нужно изменить?
Общий принцип обучения: сеть вычисляет ответ; мы сравниваем его с правильным и определяем величину ошибки; выясняем влияние каждого веса на ошибку; немного меняем веса; повторяем.
Чтобы вычислять поправки обычным методом обратного распространения, вместо жёсткой пороговой функции используют подходящие дифференцируемые операции. Так мы приходим к производной.
Зачем нейросети производная?
Астра: Помнишь физический смысл производной?
Роман: Мгновенная скорость изменения.
Астра: Именно. Возьмём простой учебный пример — ошибка зависит от одного веса:
Её минимум достигается при . Если вес больше двух, производная положительная: для уменьшения ошибки нужно уменьшить вес. Если меньше двух, производная отрицательная: вес нужно увеличить.
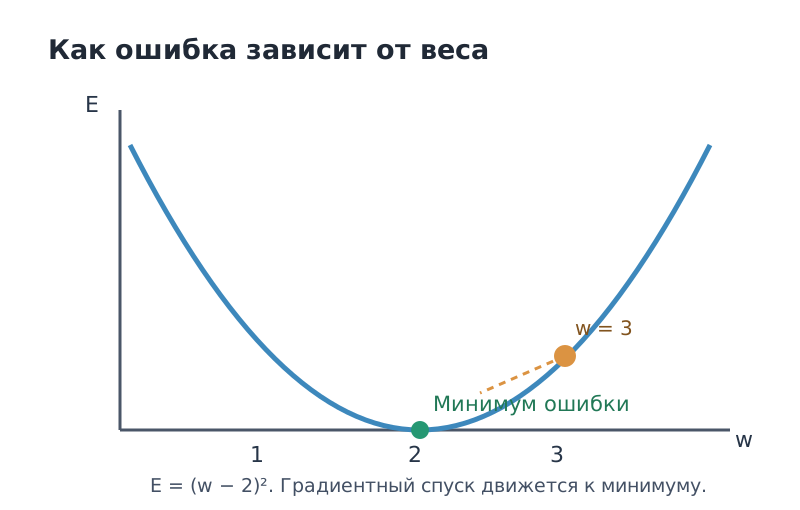
Формула градиентного спуска:
Здесь — скорость обучения, то есть величина шага. Например, при , производной и скорости обучения :
Роман: Уменьшить.
Астра: Правильно! Если производная положительная, уменьшаем вес.
Астра: А что случится при слишком большой скорости обучения?
Роман: Просто проскочим минимум.
Астра: Да. Перескочить один раз не страшно, но слишком большие шаги могут уводить от минимума всё дальше. Например, для этой функции при скорости обучения 1,5 веса последовательно принимают значения . Ошибка растёт.
А если весов миллиард?
Астра: Если весов несколько, достаточно одной производной или понадобится производная по каждому весу?
Роман: Затрудняюсь с ответом. Напрашивается ответ по одной производной для каждого веса. Но мне кажется, что если бы это было так, мы бы очень быстро упёрлись в предел возможностей.
Астра: Да, нам нужна частная производная ошибки по каждому весу. Вместе они составляют градиент. Но вычислять их повторным полным прогоном сети отдельно для каждого веса было бы невероятно дорого.
Выручает обратное распространение ошибки — backpropagation: промежуточные вычисления используются повторно, а производные эффективно передаются от выхода к более ранним слоям по цепному правилу дифференцирования.
Цепное правило
Астра: Представим цепочку:
Если увеличить на единицу, увеличится на 2, — на 6, а — на 24.
Как думаешь, влияние изменения на зависит только от первого перехода или от всей цепочки?
Роман: Первый вариант.
Астра: Не совсем. От всех переходов. Их локальные производные перемножаются:
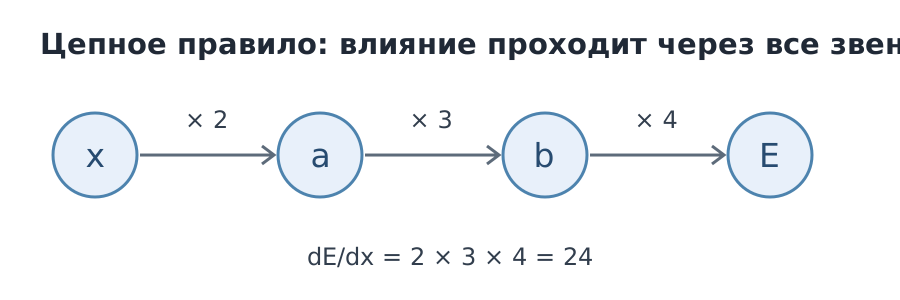
В разветвлённых вычислениях вклады разных путей складываются. Это и есть математическая основа backpropagation.
Астра: А если один из переходов вообще не реагирует на изменение входа, то есть его производная равна нулю, будет ли изменение влиять на конечную ошибку по этому пути?
Роман: Умножение на 0).
Исчезающий и взрывающийся градиент
Астра: Верно! Если множитель равен нулю, произведение тоже ноль. Даже когда производные не нулевые, но их модули меньше единицы, при многократном перемножении результат может стать ничтожно малым:
Это иллюстрирует исчезающий градиент: ранние слои могут получать очень маленькие сигналы для обновления весов.
Астра: А если в цепочке из двадцати переходов производная на каждом равна двум, градиент будет уменьшаться или расти?
Роман: Уменьшаться?
Астра: Наоборот:
Это пример взрывающегося градиента: обновления могут стать настолько большими, что обучение окажется неустойчивым. В реальных сетях всё сложнее, ведь производные различаются, а вычислительный граф может ветвиться.
Астра: Как ты думаешь, почему слишком большой градиент может мешать обучению? Подсказка: вспомни, как мы перескакивали через минимум.
Роман: Ну так ты же подсказала ответ.
Астра: Поймала! Получается не обучение, а игра «угадай, какое слово задумала Астра». Договорились: дальше вопросы будут такими, чтобы действительно пришлось подумать, а не просто повторить мою последнюю фразу.
Вместо заключения
Мы начали с одного перцептрона и обнаружили, что один пороговый перцептрон не решает XOR, а небольшая многослойная сеть — решает. Затем возник вопрос, как автоматически подобрать веса. Так мы пришли к производной, градиентному спуску, цепному правилу и обратному распространению ошибки — а заодно к проблемам исчезающего и взрывающегося градиентов.
В следующем разговоре можно будет взять сеть для XOR и проследить на конкретных числах, как один вес влияет на конечную ошибку.
Материал подготовлен на основе реального диалога Романа и Астры (ChatGPT), октябрь 2026 года; текст отредактирован для чтения. Некоторые пояснения сокращены и скомпонованы.
Комментарии
Загрузка комментариев…